
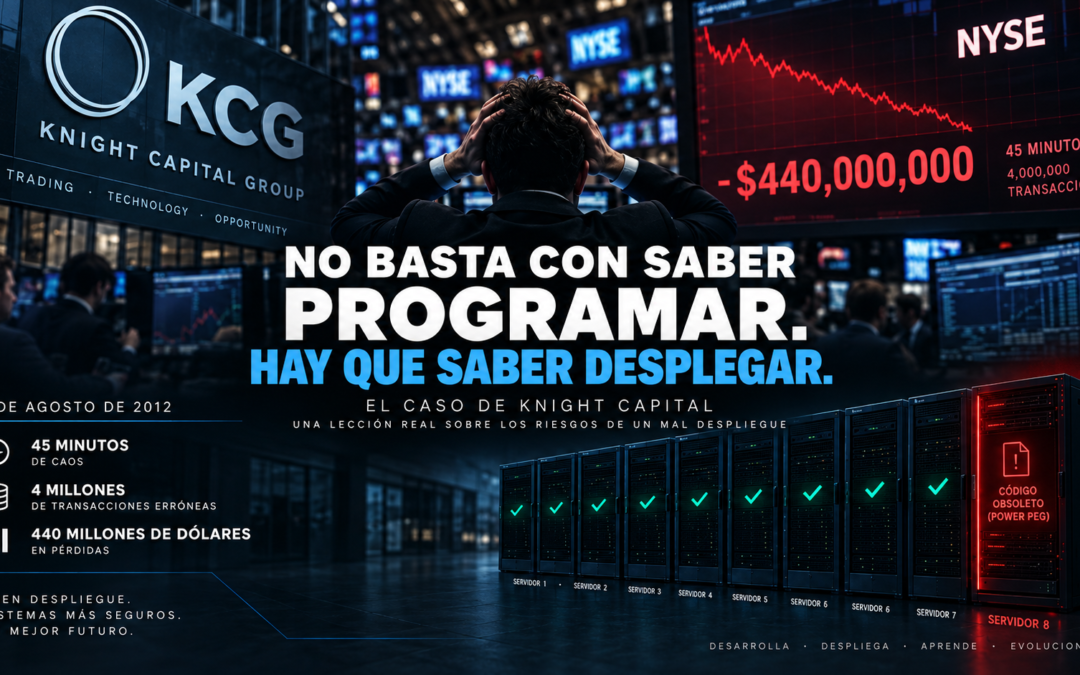
El 1 de agosto de 2012, Knight Capital Group sufrió uno de los incidentes tecnológicos más conocidos de la industria financiera.
¿La causa?
No fue simplemente “un programador escribió mal una línea de código”.
Fue una combinación de código obsoleto, despliegue manual, falta de validación, controles insuficientes y una respuesta incorrecta ante el incidente.
Knight estaba preparando su sistema de trading SMARS para participar en el nuevo Retail Liquidity Program de la Bolsa de Nueva York.
El software debía actualizarse en 8 servidores de producción.
Se actualizaron 7.
Uno quedó fuera.
Un técnico no copió la nueva versión al octavo servidor y no existía un procedimiento que obligara a una segunda persona a verificar el despliegue.
EL CÓDIGO FANTASMA
En aquel servidor permanecía una funcionalidad antigua llamada Power Peg, que Knight había dejado de utilizar años antes.
El nuevo desarrollo reutilizaba un flag que anteriormente activaba Power Peg.
En los 7 servidores actualizados, ese flag ejecutaba correctamente la nueva funcionalidad.
Pero cuando una orden llegaba al octavo servidor, el mismo flag activaba el antiguo Power Peg.
Peor todavía: aquel código había sufrido cambios años antes y no había sido probado nuevamente para comprobar qué ocurriría si volvía a ejecutarse.
EL SISTEMA COMENZÓ A OPERAR SIN CONTROL
Durante aproximadamente 45 minutos, el sistema generó millones de órdenes y terminó realizando más de 4 millones de ejecuciones sobre 397 millones de acciones.
Knight terminó con posiciones no deseadas valoradas en miles de millones de dólares.
La compañía inicialmente informó una pérdida aproximada de US$440 millones; posteriormente, la SEC describió la pérdida derivada de las posiciones como superior a US$460 millones.
Y todavía había otra señal.
Antes de que abriera el mercado, el sistema había generado 97 mensajes automáticos relacionados con Power Peg.
No estaban configurados como alertas críticas y no fueron utilizados para detectar el problema antes de la apertura.
EL INTENTO DE CORREGIRLO LO EMPEORÓ
Durante la respuesta al incidente, Knight retiró el nuevo código de los 7 servidores donde sí había sido instalado correctamente.
¿El resultado?
Esto provocó que más órdenes pudieran activar el antiguo Power Peg también en esos servidores.
La acción tomada para resolver el problema terminó agravándolo.
¿QUÉ NOS ENSEÑA KNIGHT CAPITAL?
Como desarrolladores e ingenieros de software debemos entender algo:
Nuestro trabajo no termina cuando el código funciona en nuestra computadora.
También debemos saber:
- Cómo desplegar de forma automatizada y repetible.
- Cómo verificar que todos los servidores ejecutan exactamente la misma versión.
- Cómo implementar CI/CD.
- Cómo realizar pruebas antes de producción.
- Cómo utilizar Canary Deployment o Blue-Green Deployment cuando corresponda.
- Cómo implementar monitoreo, logs y alertas reales.
- Cómo diseñar health checks.
- Cómo tener kill switches y límites de riesgo.
- Cómo preparar y probar un verdadero plan de rollback.
- Cómo eliminar código muerto u obsoleto.
- Cómo responder ante un incidente sin improvisar.
Porque un despliegue no debería ser:
“Creo que actualicé todos los servidores”.
Debe ser:
“El pipeline desplegó la versión X en todos los nodos, ejecutó las validaciones, verificó su estado y confirmó que producción está saludable”.
Esta es una de las razones por las que DevOps es tan importante.
DevOps no es solamente Docker, Git, Azure DevOps, Jenkins o Kubernetes.
Es crear procesos donde desarrollar, probar, desplegar, monitorear y recuperar software sea seguro, repetible, observable y controlado.
Knight Capital perdió cientos de millones de dólares en aproximadamente 45 minutos.
No porque no supieran desarrollar software.
Sino porque un sistema crítico llegó a producción con debilidades graves en sus procesos de despliegue, control y respuesta ante incidentes.
El código puede estar correcto.
Si el despliegue falla, el sistema falla.
#DevOps #SoftwareEngineering #CICD #Deployment #SRE #Cybersecurity #Programming #AzureDevOps #IngenieriaDeSoftware #Technology #LessonsLearned
“En software, desplegar no es el último paso del desarrollo: es el momento donde todo lo que construimos se enfrenta a la realidad. Por eso, automatizar, validar, monitorear y saber recuperar un sistema no es opcional; es parte de desarrollar software de calidad.”